一场直播持续几个小时,数字人需要介绍商品、回应问题,还要保持声音、口型和动作协调;政务大厅里,群众可能只说一句“我想办那个补贴”,数字人就得判断具体事项、申请条件和办理材料;到了企业展厅,参观者听到一半突然追问技术参数,数字人还得及时切换讲解内容。
随着语音识别、大模型、语音合成和实时渲染技术逐步成熟,数字人正从形象展示和视频播报,进入直播营销、政务咨询和一对一接待等实际场景。
道可云围绕直播数字人、政务数字人和实时交互数字人提供相应解决方案。看似都是一个虚拟形象在屏幕里说话,背后却涉及不同的技术组合。
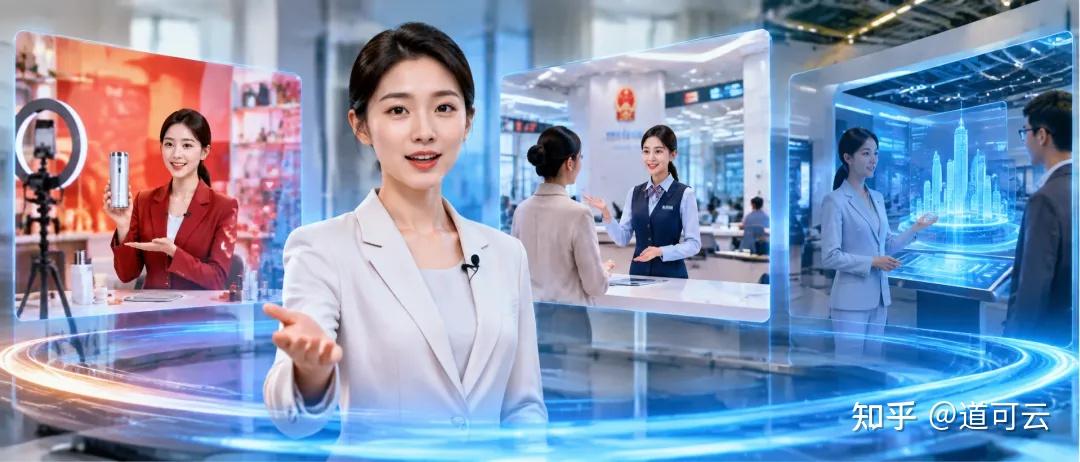
一、直播数字人:让虚拟主播持续、自然地讲好产品
直播间对数字人的要求很实际:商品信息要讲清楚,促销活动不能说错,观众提出常见问题还要及时回应。对于需要长期开展直播的企业来说,数字人还要适应不同商品和讲解主题。
直播数字人的制作通常从真人形象和声音素材采集开始。通过图像或视频素材建立人物形象,再结合声音采集、声学建模和语音合成技术,形成能够持续输出内容的数字形象。
当系统接收到文本,语音合成模块将文字转换为声音,并处理发音、语速、停顿和语气等信息。随后,系统根据语音中的音素序列计算嘴唇开合、圆展等口部动作,再映射到数字人的面部模型上。
口型同步并非简单地让嘴巴跟着声音张合。汉语中不同声母、韵母对应的口部形态存在差异,连续发音还会产生协同变化。如果只按照单个字生成口型,人物说话就容易显得机械。因此,系统需要结合连续语音信息平滑处理口部动作,并协调头部姿态、眼神和面部表情。
形象做好之后,还要解决内容问题。以智能家电直播为例,产品型号、功率、功能、使用方法和售后政策都需要准确传达。如果完全依靠固定脚本,商品更新后就要重新整理;如果交给通用大模型自由生成,又可能出现参数错误。
这就需要大模型与企业知识库配合。企业将产品资料、商品卖点、常见问题和活动规则整理成知识库,系统根据直播主题组织讲解内容。数字人生成话术时,结合预设脚本和检索到的产品信息进行表达。
直播内容还可以拆分为开场介绍、商品讲解、优惠说明和常见问题回应等模块,根据直播进程灵活调用。重复性较高的内容可以预先生成语音或视频素材,减少实时计算;临时提问和需要调整表达的部分,则交由模型处理。
道可云直播数字人方案将数字形象、语音表达与企业业务内容结合,可应用于产品讲解、品牌宣传和直播营销。对于产品线较多、讲解内容相对固定的企业,数字人能够承担标准化内容输出工作,减少重复拍摄和讲解的人力投入。
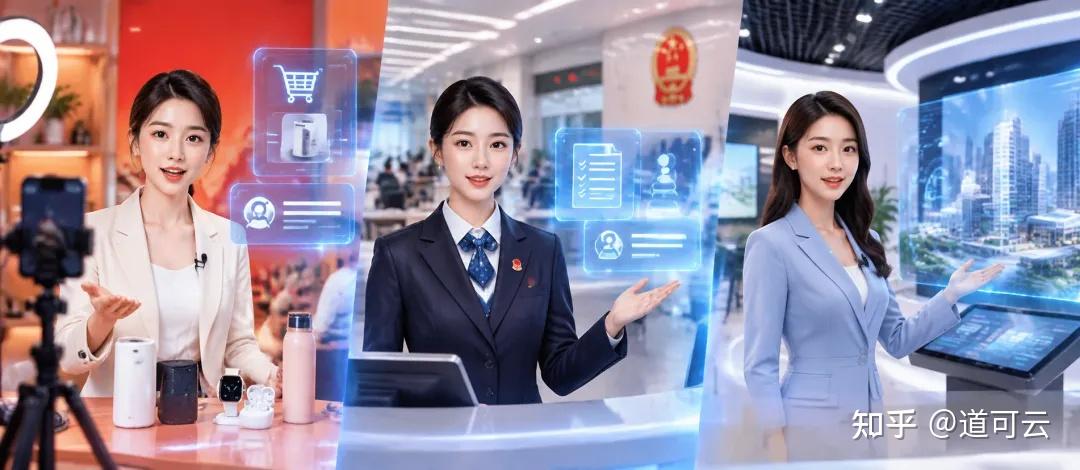
二、政务数字人:从政策文件中找到群众真正需要的答案
群众在政务大厅咨询时,很少会按照政策文件中的专业术语提问。他们更习惯说:“我今年刚退休,能领什么补贴?”“办理这个业务需要带什么材料?”这些问题可能涉及申请对象、办理时限、材料要求和适用地区,回答时需要准确找到对应政策。
因此,政务数字人需要可靠的知识检索机制。
政策文件、办事指南、服务事项和常见问题来源不同,格式也不统一。系统需要解析文档,提取标题、正文、条款和表格信息,再按照业务主题分类整理。对于复杂版式的文件,还可以借助OCR技术识别文字与表格内容。资料整理完成后,通过文本切分、向量化和索引等方式建立知识库。
当群众提出问题,系统先识别问题意图,再检索相关政策材料。这一过程涉及RAG,即检索增强生成技术:系统从知识库中找到相关内容,再交给大模型组织答案。模型负责理解问题、组织语言,知识库提供政策依据,方便后续更新资料,也能减少模型脱离实际政策自由生成的风险。
政务场景还有一个难点:相似政策可能适用于不同地区或不同时间。比如群众询问某项补贴,系统可能同时检索到旧政策和新政策。此时需要结合地区、发布时间、事项类别等元数据筛选,必要时通过重排序模型进一步判断内容相关性。
答案生成也需要设置边界。对于明确的申请条件,数字人可以分步骤说明;涉及个人情况时,可以继续询问必要信息;如果知识库没有提供明确依据,则应提示用户通过官方渠道确认。政策版本管理、信息来源和人工审核机制,都是保障政务数字人准确运行的重要环节。
道可云政务数字人方案可结合政务知识库和具体服务事项,提供政策咨询、办事引导、信息查询与公共服务讲解。例如,群众询问某项补贴如何申请,数字人可以说明申请对象、基本条件和材料清单;群众继续追问材料要求时,系统再根据办事指南检索信息并作出解释。
这种方式能够承接大量重复性咨询,减少群众查找文件和反复询问的时间,也让工作人员将更多精力放在需要人工判断的复杂事项上。
三、实时交互数字人:用户随时打断,系统也得跟得上
企业展厅里的访客可能听到一半突然询问技术参数;汽车展厅的客户原本在了解车型,话题却转到了贷款和售后。固定脚本很难应对这种随时变化的交流。
实时交互系统首先要处理连续语音。用户说话时,语音活动检测模块判断语音起止,再将音频送入语音识别模块。识别结果经过语义理解后,系统判断用户意图,调用相关知识或业务工具,最后组织回答。
其中,对话状态管理尤其重要。
假设用户先问:“这款设备多少钱?”随后又问:“那维护成本高不高?”第二个问题中的“那”与前一个问题有关。系统需要保留必要的对话上下文,判断用户指向的具体设备,再从知识库中查找对应信息。缺少这层关联能力,数字人就可能听懂了每个字,却没理解整段对话。
在企业服务场景中,数字人还可以通过工具调用衔接业务系统。例如,用户询问服务办理地点,系统可以检索对应地址;用户希望预约,则需要判断是否具备相应接口和授权条件,再调用业务系统完成操作。模型负责理解需求和选择工具,业务系统执行具体任务,最后将结果返回给模型组织表达。
实时响应速度同样影响体验。从用户说话到数字人回答,中间经过语音识别、语义分析、知识检索、模型推理、语音合成和画面驱动等环节。系统可以采用流式语音处理、并行任务调度和信息缓存等方式减少等待时间。语音识别可以在用户说话过程中提前分析,语音合成也可以分段输出,让数字人更快开始回应。
与此同时,语音和画面必须保持同步。数字人开口时,口型与面部动作要及时跟上;用户突然插话时,系统还需要判断是否中断当前播报,并根据新问题重新组织回答。
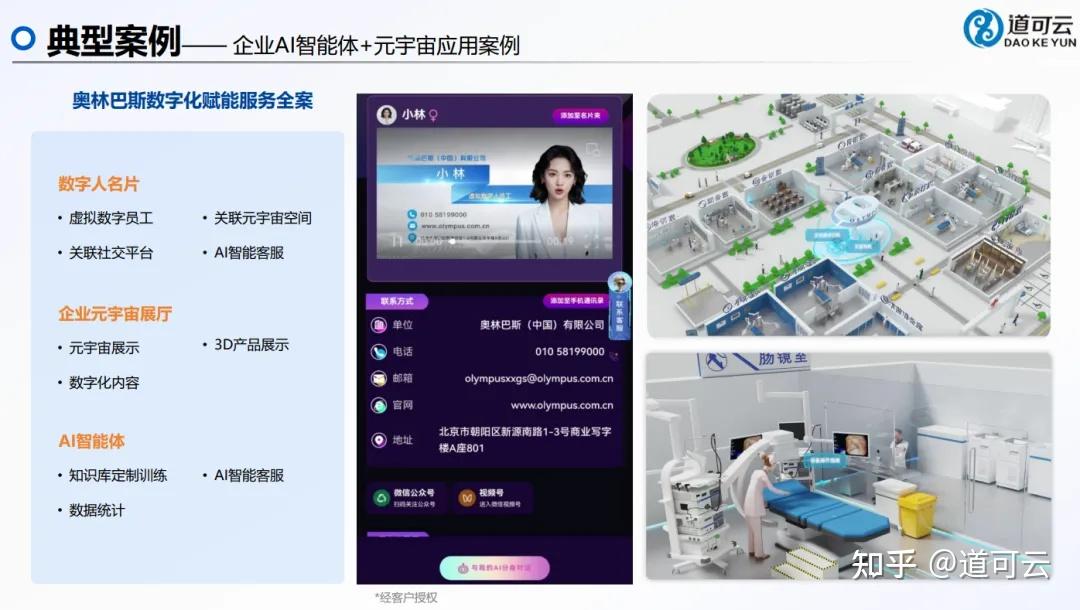
道可云实时交互数字人方案将语音识别、大模型理解、知识库调用与数字形象驱动结合,面向企业展厅、政务服务和公共服务等场景。用户可以直接通过语音提出问题,数字人结合业务资料作出回应,让信息咨询从固定菜单查询延伸到自然对话。
四、让数字人进入业务现场
直播间里,数字人需要把商品讲清楚;政务大厅里,它需要把政策说明白;一对一接待时,它还要理解上下文、及时回应用户需求。这些能力涉及语音、视觉、大模型、知识库和业务系统之间的协同。
道可云数字人产品与解决方案已在全国20余个省市的不同应用场景中落地,涉及政务服务、文旅导览、企业宣传、直播营销和公共文化服务等方向。随着相关技术不断成熟,数字人的应用重点也将从形象展示和内容播报,逐步延伸到更具体的咨询、讲解与业务服务工作中。